Transformer Block 中,Attention 先汇聚上下文信息,FFN 再对每个位置的表示进行非线性加工。理解 FFN,可以从最基本的“展开—激活—压缩”结构出发,再看激活函数如何演进为 SwiGLU 的门控结构,最后用参数量解释中间维度的选择。
1. FFN 在 Transformer 中的作用
Attention 让 token 之间交换信息,FFN 则对汇聚后的特征进一步加工。例如,一个 token 通过 Attention 获得了与上下文有关的表示,FFN 接着把这个表示映射成新的特征组合,供后续层使用。
设输入形状为 [B, S, D]:B 是 batch size,S 是序列长度,D 是每个 token 的隐藏维度。FFN 对每个 token 的 D 维向量施加相同的变换,输出仍然是 [B, S, D],从而能够与残差分支相加。
这个保持输入输出形状不变的模块,内部如何完成特征变换?关键在于临时扩展隐藏维度。
2. FFN 的“展开—压缩”结构
2.1 先沿隐藏维展开,再回到残差流的宽度
设中间维度为 M,标准 FFN 写成:
$\operatorname{FFN}(X)=\phi(XW_{up}+b_{up})W_{down}+b_{down}$
其中 φ 是激活函数,b_up 和 b_down 是偏置;下文代码与参数量计算采用无偏置版本。本文采用行向量右乘权重的记法:
| 对象 | 形状 | 作用 |
|---|---|---|
输入 X |
[B, S, D] |
每个 token 有 D 个特征 |
W_up |
[D, M] |
生成 M 个中间特征 |
| 升维结果与激活结果 | [B, S, M] |
对中间特征施加非线性 |
W_down |
[M, D] |
将中间特征重新组合为 D 维 |
| 输出 | [B, S, D] |
与残差分支形状一致 |
以 D=4096、M=16384 为例:
1
2
3
4
5
6
7
[B, S, 4096]
    → up projection
[B, S, 16384]
    → ReLU / GELU 等逐元素激活
[B, S, 16384]
    → down projection
[B, S, 4096]
整个过程保持 B 和 S 不变,只在每个 token 的特征维度上先展开、再压缩。
2.2 为什么需要中间的非线性?
暂时忽略偏置。如果没有激活函数:
$(XW_{up})W_{down}=X(W_{up}W_{down})$
两次线性变换可以合并成一次,展开的中间层无法提供额外的非线性表达能力。
加入 φ 后,模型可以根据输入产生不同的非线性响应。较宽的中间层提供更多特征通道,激活函数调节这些通道的响应,最后由 W_down 将它们组合回 D 维。
因此,FFN 的三个步骤各有作用:升维生成中间特征,激活引入非线性,降维组合输出。
2.3 用代码对应这三个步骤
1
2
3
4
5
6
7
8
9
10
11
12
from torch import nn
from torch.nn import functional as F


class StandardFFN(nn.Module):
    def __init__(self, d_model, d_ff):
        super().__init__()
        self.up = nn.Linear(d_model, d_ff, bias=False)
        self.down = nn.Linear(d_ff, d_model, bias=False)

    def forward(self, x):
        return self.down(F.gelu(self.up(x)))
这里使用 GELU 作为激活函数。保持两个投影不变,替换中间的激活函数,就会得到不同的 FFN。
3. 激活函数:ReLU、GELU 与 Swish/SiLU
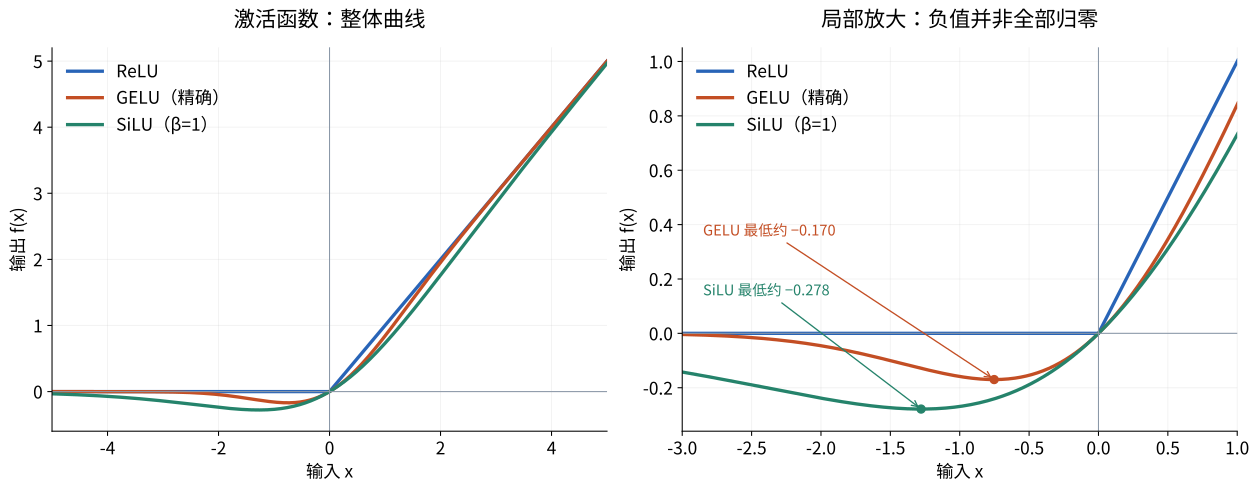
ReLU、GELU 和 SiLU 都对中间张量逐元素计算,保持形状不变。它们主要区别在于如何处理零点附近和负半轴的输入。下图使用精确 GELU,Swish 固定 β=1,即 SiLU。
3.1 ReLU:正值通过,负值归零
$\operatorname{ReLU}(x)=\max(0,x)$
ReLU 的规则很直接:正半轴输出等于输入,负半轴输出为零。它的计算简单,输出可能包含大量零值。
在 x>0 时导数为 1,在 x<0 时导数为 0,零点处存在折角。
负区间的零梯度也带来了 dying ReLU 风险:如果一个通道对训练样本持续落在负区间,它可能长期收不到来自该激活路径的有效梯度。这使得平滑地处理负值成为另一种设计思路。
3.2 GELU:用正态分布 CDF 平滑地调节输入
$\operatorname{GELU}(x)=x\Phi(x)=\frac{x}{2}\left[1+\operatorname{erf}\left(\frac{x}{\sqrt{2}}\right)\right]$
Φ(x) 是标准正态分布的累积分布函数,取值在 0 和 1 之间。可以把它理解成一个随输入变化的软系数:大正值基本原样通过,大负值被压到接近零的位置。
它与 ReLU 的明显区别出现在零点附近:负数不会全部被截断,而是形成一个小的负值凹陷。精确 GELU 的最小值约为 −0.170,出现在 x≈−0.752。
3.3 Swish 与 SiLU:用 sigmoid 调节自身
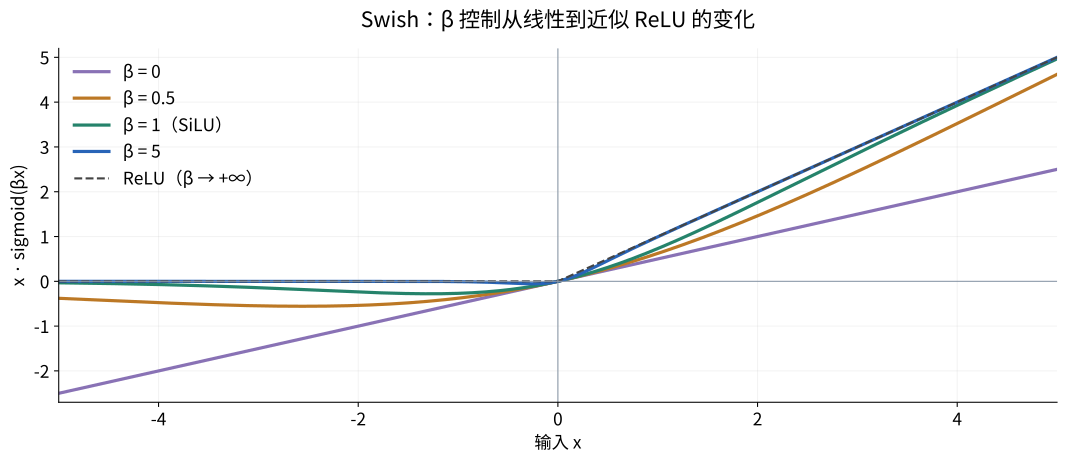
$\operatorname{Swish}_{\beta}(x)=x\operatorname{sigmoid}(\beta x)$
其中 β 可以固定或学习。当 β=1 时:
$\operatorname{SiLU}(x)=x\operatorname{sigmoid}(x)=\frac{x}{1+e^{-x}}$
SiLU 与 GELU 都是平滑函数,都在负半轴保留一个小凹陷;SiLU 的最小值约为 −0.278,出现在 x≈−1.278,负值尾部也更明显。
对一般 Swish,β=0 时结果是 x/2;当 β 趋向正无穷时,函数逐点趋向 ReLU。下图展示这个变化过程。
3.4 从梯度曲线看差异
精确 GELU 和 SiLU 的导数分别是:
$\operatorname{GELU}'(x)=\Phi(x)+x\frac{e^{-x^2/2}}{\sqrt{2\pi}}$
$\operatorname{SiLU}'(x)=s+x\,s(1-s),\quad s=\operatorname{sigmoid}(x)$
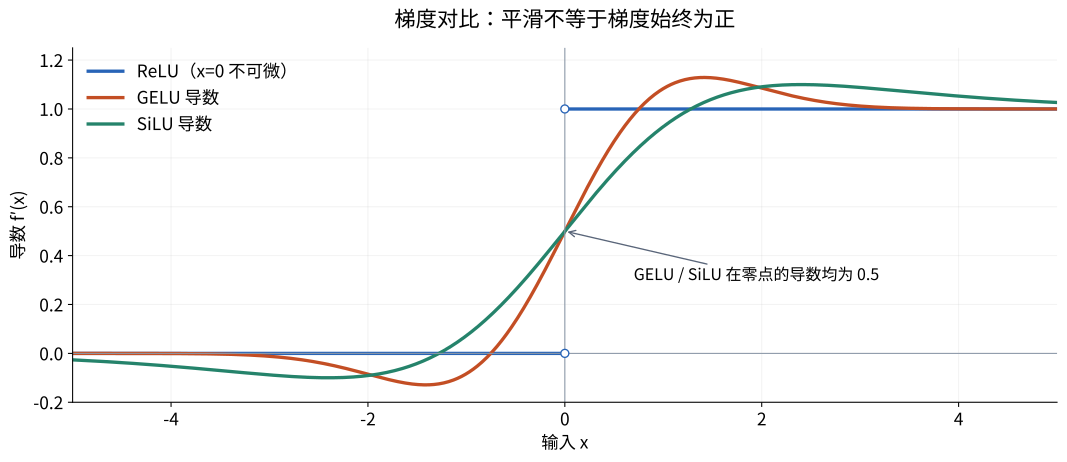
GELU 与 SiLU 的梯度连续变化,在零点都等于 0.5;在负值凹陷的左侧,梯度为负,在最低点处为零。曲线中的小凹陷与负梯度区间,正好对应这两个函数的非单调性。
| 特性 | ReLU | GELU(精确形式) | SiLU(Swish,β=1) |
|---|---|---|---|
| 核心规则 | max(0,x) |
x·Φ(x) |
x·sigmoid(x) |
| 输出范围 | [0,+∞) |
约 [−0.170,+∞) |
约 [−0.278,+∞) |
| 单调性 | 单调不减 | 非单调 | 非单调 |
| 零点可微 | 否 | 是 | 是 |
| 负半轴 | 全部置零 | 小幅负值后趋近零 | 小幅负值后趋近零 |
| 常见应用 | 原始 Transformer FFN | BERT、GPT-2 | LLaMA 等模型的 SwiGLU 门控分支 |
到这里,改变的还是单条分支上的激活函数。如果再增加一条投影分支,让一组特征调节另一组特征,就得到门控 FFN。
4. SwiGLU:多一条可学习的门控分支
4.1 从单分支激活到双分支相乘
标准 FFN 的中间状态是 φ(XW_up)。GLU 引入两套投影,一套产生内容,一套调节内容:
$U=XW_{up},\quad G=XW_{gate}$
$H_{\mathrm{GLU}}=U\odot\operatorname{sigmoid}(G)$
⊙ 表示逐元素相乘。U 是内容分支,sigmoid(G) 是门控分支:它根据当前输入,为每个中间通道生成一个缩放系数。
SwiGLU 将这里的 sigmoid 换成 Swish。在本文讨论的常见 β=1 实现中,完整 FFN 是:
$\operatorname{FFN}_{\mathrm{SwiGLU}}(X)=\left[\operatorname{SiLU}(XW_{gate})\odot(XW_{up})\right]W_{down}$
4.2 门控如何调节内容?
SwiGLU 用 SiLU(G) 调节内容分支 U。SiLU 的输出可以为负,也可以大于 1,因此这种调节包括抑制、放大和改变符号。
例如令两条分支在某个 token 上的投影结果为:
1
2
3
4
5
G = [-1,    0,    2]
U = [ 2,    3,    4]

SiLU(G) ≈ [-0.269, 0, 1.762]
H       ≈ [-0.538, 0, 7.046]
这个例子中,三个内容通道分别被反向缩放、归零和放大。SwiGLU 增加的正是两组可学习特征之间的乘性交互:一组特征决定内容,另一组特征调节其贡献。
4.3 对应的 PyTorch 实现
1
2
3
4
5
6
7
8
9
10
11
class SwiGLUFFN(nn.Module):
    def __init__(self, d_model, d_ff):
        super().__init__()
        self.gate = nn.Linear(d_model, d_ff, bias=False)
        self.up = nn.Linear(d_model, d_ff, bias=False)
        self.down = nn.Linear(d_ff, d_model, bias=False)

    def forward(self, x):
        gate = F.silu(self.gate(x))
        content = self.up(x)
        return self.down(gate * content)
标准 FFN 使用 up、down 两个投影;SwiGLU 增加了 gate 投影。多出来的矩阵会增加多少参数,取决于中间维度的大小。
5. 参数量:两个矩阵与三个矩阵
5.1 先写通式
忽略偏置,标准 FFN 有两个矩阵:
$P_{\mathrm{standard}}=DM+MD=2DM$
SwiGLU 有三个矩阵:
$P_{\mathrm{SwiGLU}}=DM+DM+MD=3DM$
在相同的 D 和 M 下,SwiGLU 的参数量是标准 FFN 的 1.5 倍。要让两者保持相近的参数规模,就需要缩小 SwiGLU 的中间维度。
5.2 用 D=4096 算一次
| 结构 | 中间维度 M | 每个矩阵的参数量 | 矩阵数 | FFN 总参数量 |
|---|---|---|---|---|
| 标准 FFN | 16384 | 67,108,864 | 2 | 134,217,728 |
| SwiGLU | 11008 | 45,088,768 | 3 | 135,266,304 |
标准 FFN 约有 1.34 亿参数,SwiGLU 约有 1.35 亿参数。SwiGLU 虽然多了一个矩阵,但每个矩阵更小,因此总参数量接近。下一节会推导 16384 和 11008 这两个中间维度的来源。
5.3 FFN 在 Block 中的参数占比
对于 Q、K、V 和输出投影都是 [D,D] 的标准 MHA:
$P_{\mathrm{Attention}}\approx4D^2$
采用 M=4D 的标准 FFN:
$P_{\mathrm{FFN}}=8D^2$
忽略 Norm 和偏置后,FFN 在这个 Block 中的参数占比约为:
$\frac{8D^2}{4D^2+8D^2}=\frac{2}{3}$
这解释了为什么在这种标准 MHA Block 中,FFN 占据大部分参数:它的中间层展开使两个投影矩阵的参数总量达到 Attention 四个投影矩阵的两倍。
6. 中间维度为什么常见 4 倍和 8/3 倍?
6.1 标准 FFN 的 4 倍扩展
原始 Transformer 使用 D=512、M=2048,也就是 M=4D。后续许多标准 FFN 延续了这个比例。
更宽的中间层提供更多特征通道,同时增加参数量、计算量和中间激活开销。4 倍是表达能力与开销之间的常见经验折中,具体比例随模型设计而变化。
6.2 8/3 倍来自配平参数预算
标准 FFN 采用 4 倍中间宽度时:
$P_{\mathrm{standard}}=2D(4D)=8D^2$
如果 SwiGLU 仍然使用 4D:
$P_{\mathrm{SwiGLU}}=3D(4D)=12D^2$
参数量会增加 50%。为了保持同样的预算,令:
$3DM=8D^2\quad\Longrightarrow\quad M=\frac{8}{3}D$
因此,8/3 倍来自参数预算配平:矩阵从两个增加到三个,每个矩阵的中间宽度就缩小为原来的 2/3。
6.3 为什么 LLaMA-2-7B 使用 11008?
对于 D=4096:
$\frac{8}{3}\times4096=10922.\overline{6}$
把这个理想宽度向上对齐到 256 的倍数:
$M=256\left\lceil\frac{(8/3)\times4096}{256}\right\rceil=256\times43=11008$
对应的参数量比 8D² 多约 0.78%,因此表格中的两种结构只是近似等参数,而非完全相等。
这里的 256 倍数是该模型采用的维度对齐方式,便于配合矩阵乘的分块执行。由此,从标准 FFN 到 SwiGLU 的维度选择就连成了完整的一条线:4D 的标准宽度 → 按三矩阵预算调整为 8D/3 → 对齐得到实际宽度。
参考资料
- Attention Is All You Need
- Gaussian Error Linear Units (GELUs)
- Searching for Activation Functions
- GLU Variants Improve Transformer
- Llama 2: Open Foundation and Fine-Tuned Chat Models
